
Proxmox Backup Server
Backup-Server: ein 30-Tage-Backup-Kalender pro Maschine, fehlgeschlagene Tasks mit ihren Logs, geplante Jobs (Sync, Verify, Prune, Garbage Collection), Datastores, Platten und ZFS-Pools, ausstehende Updates, die Dienste und Paketversionen des Servers selbst, und die Tape-Stufe, falls vorhanden.
Die Monitorseite
Abschnitt betitelt „Die Monitorseite“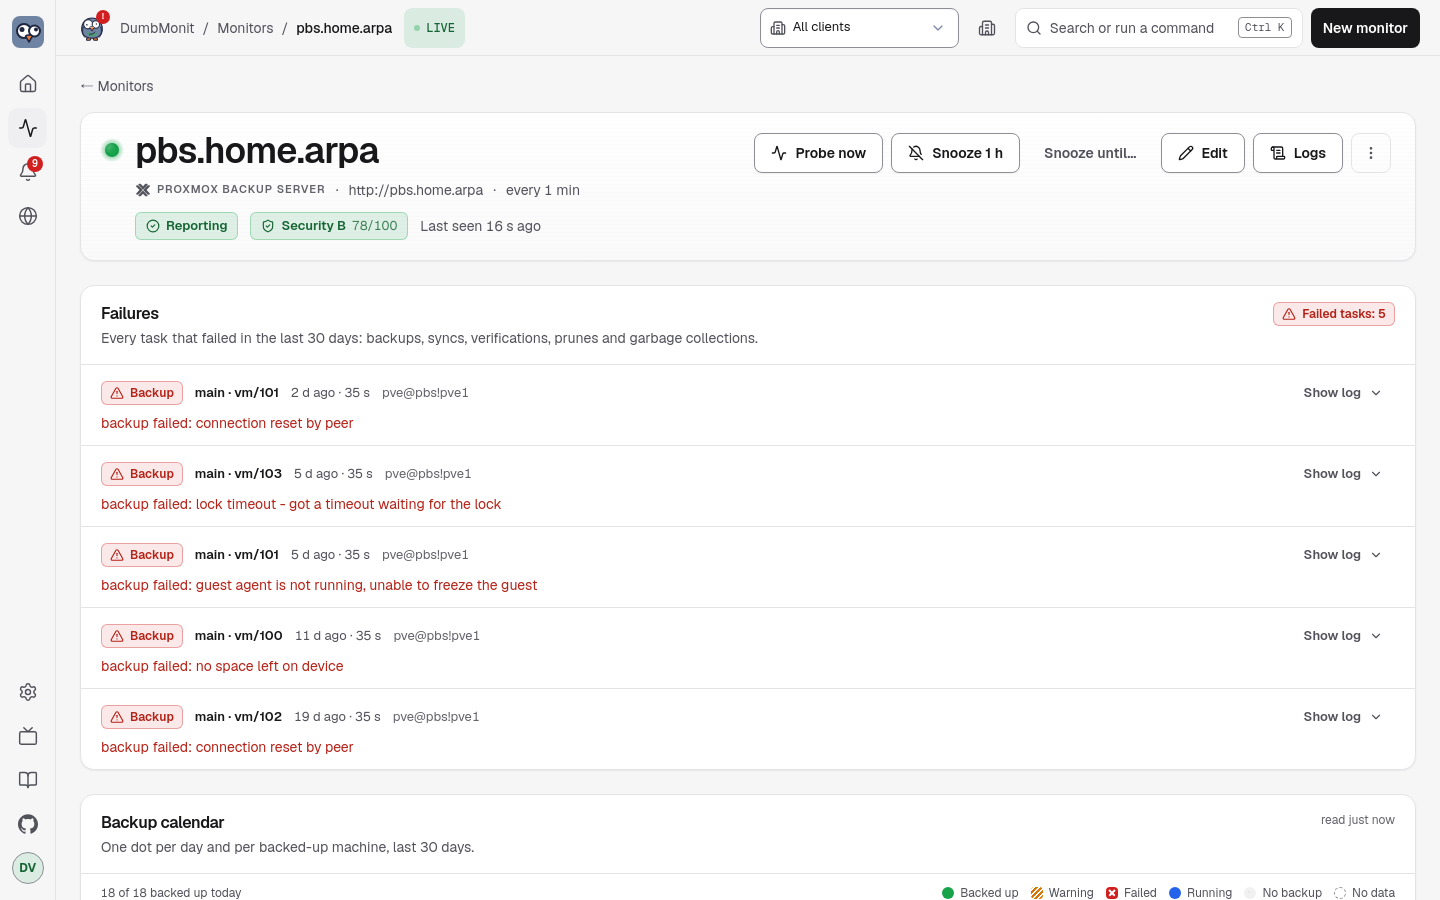
Über die generischen Diagramme hinaus zeigt ein PBS-Monitor sechs Panels, aus dem gelesen, was die Abfrage gespeichert hat — das Öffnen der Seite fragt PBS selbst nie ab:
- Failures — jeder in den letzten 30 Tagen fehlgeschlagene Task
(Backup, Sync, Verify, Prune, GC), neueste zuerst, mit seiner Art,
dem Ziel, wann er begann und PBS’ eigener Fehlermeldung. Show log
holt auf Anfrage die letzten Zeilen des Task-Logs von PBS
(
/nodes/localhost/tasks/{upid}/log). - Backup calendar — eine Zeile pro gesicherter Maschine
(Datastore, Namespace,
type/id, und der Gastname, wenn PVE ihn in die Snapshot-Notizen schrieb), ein Punkt pro Tag: teal, wenn an diesem Tag ein Backup gelang (ein Task endeteOK, oder ein Snapshot existiert — synchronisierte Gruppen haben keinen lokalen Task), rot, wenn ein Backup-Task fehlschlug und keines gelang, gelb, wenn das Backup da ist, aber seine Verifizierung fehlschlug, blau, während eines läuft, grau, wenn nichts geschah. Der Tooltip jedes Punkts gibt Zeit, Größe, Dauer und einen Fehlerausschnitt; die Zeile sagt, wann der letzte Erfolg und der letzte Fehlschlag waren, die Snapshot-Anzahl, die Größe des neuesten Snapshots und die Aufbewahrung des zutreffenden Prune-Jobs. Eine Maschine, deren Backups alle fehlschlagen, hat überhaupt keinen Snapshot und erscheint trotzdem — aus ihren Tasks. - Jobs — jeder Sync-, Verify- und Prune-Job und die GC jedes Datastores, mit Zeitplan, letztem Lauf, Ergebnis, nächstem Lauf; ein fehlgeschlagener letzter Lauf erhält eine rote Anzeige und den Fehlertext, Fehlschläge sortieren zuerst.
- Tape — nur, wenn der Server eine Tape-Stufe hat. Tape-Backup-Jobs mit ihrem Pool, Laufwerk, dem Label des nächsten erwarteten Bands, dem letzten Lauf und seinem Fehler; Medien-Pools mit ihrer Zuweisung und Aufbewahrungsrichtlinien, wie viele Bänder sie halten, wie viele abgelaufen sind und ob sie verschlüsselt sind; Laufwerke und Wechsler; und die Bänder selbst mit ihrem Status, Media-Set, Standort und geschriebenen Bytes.
- Datastores and disks — Nutzungsbalken, PBS’ eigene
Füllstandsvorhersage, Deduplizierungsfaktor, letzte GC;
ZFS-Pools mit ihrer Gesundheit; physische Platten mit dem
SMART-Urteil und SSD-Verschleiß, und die vollständige SMART-Tabelle
auf Anfrage (
/nodes/localhost/disks/smart). Pro Datastore zeigt es auch eine Wartungs- oder “Not mounted”-Anzeige, eine “Busy: n writes, n reads”-Anzeige, das pro Tag gemessene Wachstum und über wie viele Tage Historie, wie viele Maschinen jeder Art es hält, wie lange die letzte GC dauerte, und eine Warnzeile, wenn diese GC unlesbare Chunks fand. - Server — die systemd-Units, mit den hervorgehobenen, auf die der Server nicht verzichten kann; die Proxmox-Paketversionen (installiert, verfügbar, laufend), mit einer “Restart pending”-Anzeige, wenn der Daemon hinter seinem Paket zurückliegt; das Zertifikat und sein Ablauf; und die Traffic-Control-Regeln mit ihren Obergrenzen und was sie gerade tragen.
Der Kalender teilt Tage an der lokalen Mitternacht des Browsers
auf. Seine Historie kommt aus der Task-Liste: Die erste Abfrage nach
einem Start liest die letzten 30 Tage
(/nodes/localhost/tasks?since=…&limit=5000), spätere Abfragen nur
das Task-Fenster, und der Server behält die Vereinigung in SQLite
(pbs_task_history, 35 Tage, höchstens 10.000 Tasks pro Monitor),
sodass der Kalender Neustarts überlebt.
Was beobachtet wird
Abschnitt betitelt „Was beobachtet wird“Alle Metriken haben das Präfix dumbmonit_pbs_.
| Familie | Metriken | Labels |
|---|---|---|
| Knoten | node_cpu_percent, node_cpu_count, node_iowait_percent (CPU-Zeit wartend auf I/O — auf einem Backup-Server sagt das, dass die Platten gesättigt sind), node_load1/5/15, node_memory_used/total/free_bytes, node_memory_used_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_uptime_seconds, node_kernel_info, version_info | |
| Datastores | datastore_available, datastore_bytes_used/total/avail, datastore_used_percent, datastore_estimated_full_seconds (PBS’ eigene Schätzung; fehlt, solange ihr Daten fehlen oder die Nutzung sinkt), datastore_dedup_factor, datastore_removable_unmounted (1, wenn ein Wechsel-Datastore notmounted ist — kein Fehler, er ist einfach nicht eingesteckt; Label mount_status), datastore_backend_info (Label backend, filesystem oder s3), datastore_maintenance (1, wenn der Datastore zur Wartung gehalten wird; Label mode, offline, read-only…), datastore_groups und datastore_snapshots (Label type, vm/ct/host/other), datastore_active_reads, datastore_active_writes (was den Datastore gerade hält — das erklärt eine nicht fertig werdende Garbage Collection), datastore_growth_percent_per_day, datastore_growth_bytes_per_day, datastore_history_days | datastore |
| Garbage Collection | gc_last_removed_bytes, gc_last_pending_bytes, gc_last_run_ok (PBS 3.3+), gc_last_success_age_seconds, gc_last_duration_seconds, gc_disk_chunks, gc_last_pending_chunks, gc_last_removed_chunks, gc_bad_chunks (von der GC gefundene unlesbare Chunks, unverändert gelassen — Korruption, kein freizugebender Platz: ein Backup, das auf sie verweist, kann nicht mehr wiederherstellt werden), verify_last_success_age_seconds, sync_last_success_age_seconds | datastore |
| Backup-Gruppen | backup_count, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_last_verified (1 verifiziert, 0 fehlgeschlagen, fehlt, falls nie verifiziert) | datastore, namespace, backup_type, group |
| Namespaces | namespace_groups, namespace_snapshots (Root-Namespace ist namespace="") | datastore, namespace |
| Tasks im Fenster | tasks_running, tasks_ok, tasks_failed | worktype (backup, verificationjob, garbage_collection, prune, syncjob…) |
| Jobs | job_enabled, job_last_ok (1 für OK oder WARNINGS: n, sonst 0, fehlt, falls der Job nie lief), job_never_run (1, wenn ein Job aktiviert ist, einen Zeitplan hat und nie lief — er hat weder einen Fehlschlag noch einen Erfolg, ist also sonst nirgends sichtbar), job_last_run_age_seconds, job_next_run_seconds (negativ, wenn überfällig), sync_jobs_total, verify_jobs_total, prune_jobs_total; Alias sync_job_last_ok für die Regel | job, datastore, kind (sync, verify, prune); remote (remote:remote-store, oder local) auf Sync-Jobs — der Alias trägt job, datastore, remote |
Tape (Option tape, standardmäßig aus, fünf Aufrufe) | tape_backup_job_last_ok, tape_backup_job_never_run, tape_backup_job_last_run_age_seconds, tape_backup_job_next_run_seconds, tape_backup_jobs_total; tape_drive_info (Vorhandensein-Zeitreihe), tape_drives_total, tape_changers_total, tape_media_pools_total; tape_media_total, tape_media_writable, tape_media_expired, tape_media_bytes_used | job, datastore, pool, drive auf den Jobs; drive, vendor, model, changer auf tape_drive_info; pool auf den Medienzählungen |
| Platten (dieselben Namen wie Proxmox VE) | node_disk_size_bytes, node_disk_smart_failed (0 passed, 1 failed; fehlt, wenn SMART kein Urteil gab), node_disk_health_info (Vorhandensein-Zeitreihe; Labels health, serial, used), node_disk_wearout_percent (verbrauchte Ausdauer, nur SSD, wie PBS sie anzeigt: 100 − wearout) | disk (/dev/sda), model, type |
| ZFS-Pools (dieselben Namen wie Proxmox VE) | node_zfs_pool_degraded (0 ONLINE, sonst 1), node_zfs_pool_health_info (Label health), node_zfs_pool_size_bytes, node_zfs_pool_alloc_bytes, node_zfs_pool_free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | pool |
| Updates | node_updates_pending (Anzahl der Pakete mit verfügbarem Update) | |
Versionen (Option updates, von /nodes/localhost/apt/versions) | node_package_upgradable (1/0), node_package_info (Vorhandensein-Zeitreihe; Labels installed, available, running), node_running_version_stale (1, wenn das installierte Paket proxmox-backup-server nicht mehr der laufende Daemon ist — das Paket wurde aktualisiert, die Dienste wurden nicht neu gestartet) | package, begrenzt auf proxmox-backup, proxmox-backup-server, proxmox-backup-client, proxmox-kernel-helper |
Dienste (Option services, ein Aufruf) | node_service_active (1 laufend, 0 nicht), node_service_enabled (fehlt für eine static-Unit, die eine andere Unit hereinzieht und daher weder aktiviert noch deaktiviert ist), node_services_total | service, expected ("1" für proxmox-backup, proxmox-backup-proxy und proxmox-backup-banner, die Units, auf die der Server nicht verzichten kann; jede andere Unit erhält trotzdem ihre Zeitreihe, mit expected="0", und löst nie einen Alarm aus) |
Zertifikat (Option certificates, standardmäßig aus) | node_certificate_expires_seconds, negativ nach Ablauf | certificate (der Dateiname), issuer |
Traffic Control (Option traffic_control) | traffic_rate_in_bytes, traffic_rate_out_bytes (zum Zeitpunkt der Abfrage gemessen), traffic_limit_in_bytes, traffic_limit_out_bytes (die konfigurierte Obergrenze, aus PBS’ Dezimal-Strings wie 100 MB geparst; fehlt, wenn diese Richtung unbegrenzt ist, statt einer Null, die sich als “alles ist blockiert” lesen würde), traffic_rules_total | rule |
| Limits und Sammlung | backup_groups_total, backup_groups_dropped, up, scrape_errors, scrape_duration_seconds |
Ein Task, der mit WARNINGS: n endet, zählt als erfolgreich. Aufrufe
pro Datastore sind auf vier parallel begrenzt: Das Auflisten von
Snapshots liest die Indizes des Datastores, und ein Schub würde das
laufende Backup verlangsamen.
Die Job-Listen sind nicht auf das Task-Fenster begrenzt: Ein
Sync-Job, der seit drei Wochen fehlschlägt, wird weiterhin als
fehlschlagend gemeldet. Ein nie gelaufener Job hat keine
job_last_ok-Zeitreihe, erhält aber job_never_run, und die Regel
“PBS job never ran” feuert genau auf diesen Fall.
Garbage Collection wird mit einem einzigen /admin/gc-Aufruf
gelesen, der jeden Datastore auf einmal abdeckt, wo früher ein
/admin/datastore/{store}/gc pro Datastore nötig war; dieser
Pro-Datastore-Aufruf bleibt als Fallback, wenn /admin/gc nicht
verfügbar ist — ein älteres PBS, oder ein fehlendes Recht — und wird
nicht als Fehler gezählt. /admin/gc trägt auch die Laufdauer und
die Chunk-Zähler, die der Pro-Datastore-Aufruf nicht hat.
gc_last_run_ok kommt von last-run-state auf PBS 3.3 und später;
auf älteren Versionen fällt es auf den neuesten Garbage-Collection-
Task des Fensters zurück. Die Pro-Art-Zählungen kommen von
/admin/datastore/{store}/status?verbose=1: Ohne verbose gibt PBS
nur die Größen zurück, die /status/datastore-usage schon gab.
/admin/datastore/{store}/namespace gibt den gesamten Namespace-Baum
zurück, sodass in Unter-Namespaces nichts verloren geht —
pve/site-a/rack1 wird wie das Root gezählt. Platten und Pools
kommen von /nodes/localhost/disks/list und
/nodes/localhost/disks/zfs (Option disks; ein 403 wird
toleriert, ebenso das 400, mit dem ein Server ohne ZFS antwortet:
keine Pool-Zeitreihe, kein Scrape-Fehler).
datastore_growth_percent_per_day ist ein Least-Squares-Fit über die
von PBS selbst mit /status/datastore-usage zurückgegebene
Nutzungshistorie: ein Nutzungs-Anteil zwischen 0 und 1, ein Punkt
alle dreißig Minuten über den letzten Monat, mit null-Löchern, die
übersprungen statt gefüllt werden — ein ausgeschalteter Server wuchs
nicht, während er aus war. Das sind dieselben Zahlen hinter PBS’
eigener “full in N days”-Vorhersage. Mindestens acht gemessene Punkte
sind nötig, bevor irgendetwas veröffentlicht wird, und
datastore_history_days sagt, wie viel Historie die Steigung
abdeckt. Ein negativer Wert ist kein Fehler: Das Pruning gewinnt mehr
zurück, als die Backups hinzufügen.
Überhaupt nichts wird für Tape veröffentlicht, wenn der Server kein Laufwerk, keinen Wechsler, keinen Pool und keinen Tape-Job hat: Eine Installation ohne Tape darf nicht ein Dutzend Null-Zeitreihen anwachsen lassen, die wie eine Tape-Stufe in Schwierigkeiten lesen. Ein Band, das zu keinem Pool gehört, leeres Medium oder aus einem Pool entferntes Medium, ist in keiner Pool-Zählung.
Jede gesicherte Maschine — Host, VM oder Container — wird auch unter
der generischen Familie veröffentlicht, die sich jede DumbMonit-
Integration teilt, die geschützte Geräte verfolgt —
dumbmonit_client_device_*, ohne pbs-Präfix, vollständig
dokumentiert unter Client-Geräte.
Nichts Neues wird von PBS verlangt: Es ist dasselbe letzte
Snapshot-Datum, das schon hinter backup_last_timestamp_seconds
steht, erneut unter der geteilten Familie veröffentlicht, sodass
eine Regel und eine Tabelle PBS neben jeder anderen Integration
bedienen, die ein Gerät schützt.
| Metrik | Was | Labels |
|---|---|---|
last_backup_timestamp_seconds | Derselbe Zeitpunkt wie backup_last_timestamp_seconds für diese Gruppe | device, type, os, user, kind |
stale_seconds | Positiv, sobald eine Gruppe device_stale_days (standardmäßig 3) ohne neuen Snapshot überschritten hat; treibt die Regel Client device stale | device, type, os, user, kind, signal (immer backup) |
Wissenswerte Einschränkung: PBS verzeichnet für eine gesicherte
Maschine keine separate “Verbindung”, nur Backups —
last_seen_timestamp_seconds und das Signal connection werden hier
nie veröffentlicht; ein Gerät zeigt last_connection als ”—” in der
Tabelle der Monitorseite. Das im Alarm benannte Gerät ist der
Gastname aus den Snapshot-Notizen, wenn PVE einen schrieb, sonst
type/id, wie im Backup-Kalender.
Geltende eingebaute Regeln: Monitor unreachable, PBS datastore almost full, PBS datastore filling up, PBS backup too old (pro Backup-Gruppe: kein neuer Snapshot seit zwei Tagen — bearbeiten Sie den Schwellenwert der Regel für ein längeres Fenster), PBS backup verification failed, PBS task failed, PBS garbage collection too old, PBS garbage collection failed, PBS corrupt chunks found, PBS sync job failed, PBS prune job failed, PBS verification job failed, PBS job never ran, PBS datastore not mounted, PBS service down, PBS restart pending after upgrade, PBS certificate expiring, PBS tape backup failed, PBS disk SMART failure, PBS SSD worn out, PBS ZFS pool degraded, PBS updates pending, Client device stale. Benachrichtigungen benennen den betroffenen Job, Datastore oder die Backup-Gruppe.
Was in PBS vorzubereiten ist
Abschnitt betitelt „Was in PBS vorzubereiten ist“Die Schritte unten sind die, die der Hinweis neben dem Formular zeigt. Das Prinzip: ein für die Überwachung reservierter Benutzer, ein Token mit einer nur-lesenden Rolle — nie das Konto, mit dem Sie sich einloggen.
-
Öffnen Sie eine Shell auf dem Backup-Server (in der Web-UI: Administration → Shell; oder SSH) und erstellen Sie einen für die Überwachung reservierten Benutzer. Er braucht kein Passwort: Das Token ist, was sich einloggt.
proxmox-backup-manager user create dumbmonit@pbs --comment "DumbMonit monitoring" -
Erstellen Sie das API-Token des Benutzers. Der Befehl gibt die Token-ID und ihr Secret aus: Kopieren Sie beide jetzt, PBS zeigt das Secret nie wieder.
proxmox-backup-manager user generate-token dumbmonit@pbs monitor -
Geben Sie das nur-lesende Minimum, pro Pfad — dem Token und dem es besitzenden Benutzer. Die effektiven Rechte eines Tokens sind die Schnittmenge seiner eigenen ACL und der seines Benutzers: nur dem Token gewährt, ergeben sie überhaupt nichts, und PBS meldet das nirgendwo. Jede Zeile wird daher zweimal geschrieben.
DatastoreAuditauf/datastore(Datastore.Audit) liest die Datastores, Snapshots, Verify- und Prune-Jobs und GC;Auditauf/system(Sys.Audit) liest den Knotenstatus, die Task-Liste und Task-Logs, die Dienste, die Traffic-Control-Regeln, die Platten und ZFS-Pools.proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /datastore DatastoreAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /system Audit --auth-id 'dumbmonit@pbs!monitor'Optional, und ebenfalls zweimal.
RemoteAuditauf/remote(Remote.Audit) zeigt die Sync-Jobs, die von einem Remote ziehen: Die eingebaute RolleAuditdeckt nurSys.AuditundDatastore.Audit, und ohneRemote.Auditwird ein solcher Job nicht abgelehnt, er fehlt einfach in der Job-Liste.TapeAuditauf/tape(Tape.Audit) liest die Tape-Stufe.Auditauf/(Sys.Auditauf oberster Ebene) listet ausstehende Paket-Updates, und deckt auch/datastoreund/systemab, falls Sie weniger Zeilen bevorzugen. Ohne sie werden diese Elemente still übersprungen, nichts sonst ändert sich. Nichts hier kann schreiben: Der Collector führt nurGETs aus.proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /remote RemoteAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update /tape TapeAudit --auth-id 'dumbmonit@pbs!monitor'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs'proxmox-backup-manager acl update / Audit --auth-id 'dumbmonit@pbs!monitor' -
Prüfen Sie, bevor Sie die Shell verlassen, was das Token tatsächlich lesen kann. Der Befehl gibt seine effektiven Rechte aus, Pfad für Pfad; ein leeres Ergebnis bedeutet, dem Benutzer fehlt die ACL, die das Token hat — der Fall, in dem der Monitor perfekt lebendig aussieht und nichts meldet.
proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' -
Fügen Sie die Token-ID in DumbMonits Feld Token ID ein und das Secret in sein Feld Secret.
dumbmonit@pbs!monitor -
Bevorzugen Sie die Web-UI? Configuration → Access Control: Users → Add, dann API Tokens → Add, dann Permissions → Add. Fügen Sie jede Berechtigung zweimal hinzu, einmal als User Permission für
dumbmonit@pbsund einmal als API Token Permission fürdumbmonit@pbs!monitor: mit Pfad/datastoreund RolleDatastoreAudit, dann erneut mit Pfad/systemund RolleAudit. Eine Token-Berechtigung allein gewährt nichts. -
Geben Sie in DumbMonit die Serveradresse ein, zum Beispiel “pbs.lan” oder “pbs.lan:8007”.
Herstellerdokumentation: PBS API tokens.
Credentials
Abschnitt betitelt „Credentials“| Credential | Felder |
|---|---|
| API-Token (empfohlen) | Token ID: Benutzer, Realm und Token-Name, wie PBS sie zeigt, dumbmonit@pbs!monitor. Secret: die einmal beim Erstellen des Tokens gezeigte UUID. DumbMonit sendet sie als den von PBS erwarteten Header PBSAPIToken=user@pbs!name:secret. |
| Benutzername / Passwort | user@pbs (oder @pam) und das Passwort. Ein Ticket wird erhalten, gecacht und zehn Minuten vor seinem Zwei-Stunden-Ablauf erneuert. |
Die API akzeptiert das Token in zwei Teilen (token_id + secret)
oder, wie ältere Versionen es taten, als einen String token =
user@pbs!name=secret; beide werden gleich gespeichert. Ein
vollständiges, in Token ID eingefügtes Token wird vom Formular
getrennt.
Rechte, nur-lesend, und zweimal gewährt: Die effektiven Rechte eines
Tokens sind die Schnittmenge seiner eigenen ACL und der seines
Benutzers, daher muss jede Rolle unten sowohl dumbmonit@pbs als
auch dumbmonit@pbs!monitor gegeben werden. Am einfachsten: die
eingebaute Rolle Audit auf /, plus RemoteAudit auf /remote
für Sync-Jobs und TapeAudit auf /tape für die Tape-Stufe —
Audit deckt nur Sys.Audit und Datastore.Audit, und diese zwei
Rollen existieren genau deshalb, weil es das nicht tut. Pro
Endpunkt:
| Endpunkt | Braucht |
|---|---|
GET /version | jeder authentifizierte Benutzer |
GET /nodes/localhost/status, GET /nodes/localhost/tasks, GET /nodes/localhost/tasks/{upid}/log | Sys.Audit auf /system (Audit auf /system) |
GET /nodes/localhost/disks/list, …/disks/smart, …/disks/zfs | Sys.Audit auf /system (Audit auf /system); ein 403 wird toleriert: keine Platten-Zeitreihe, kein Scrape-Fehler. …/disks/zfs antwortet mit 400 auf einem Server ohne ZFS, genauso toleriert |
GET /nodes/localhost/services, GET /admin/traffic-control | Sys.Audit auf /system (Audit auf /system); ein 403 wird toleriert: keine Zeitreihe, kein Scrape-Fehler |
GET /nodes/localhost/certificates/info | Sys.Modify auf /system — ein Schreib-Recht, weshalb die Option certificates standardmäßig aus ist und ein Monitoring-Token es nicht haben sollte |
GET /status/datastore-usage, GET /admin/gc, GET /config/datastore, GET /admin/datastore/{store}/gc, …/status, …/active-operations, …/namespace, …/snapshots | Datastore.Audit auf /datastore/{store} (DatastoreAudit auf /datastore) |
GET /admin/verify, GET /admin/prune | gelistet für die Datastores, wo das Token Datastore.Audit hat; andere Jobs werden still ausgelassen |
GET /admin/sync | Datastore.Audit auf dem Datastore und Remote.Audit auf /remote/{remote} (RemoteAudit auf /remote); andere Jobs werden still ausgelassen |
GET /nodes/localhost/apt/update, …/apt/versions | Sys.Audit auf / (Audit auf /); ein 403 wird toleriert: keine Update- oder Versions-Zeitreihe, kein Scrape-Fehler |
GET /tape/backup, /tape/drive, /tape/changer, /config/media-pool, /tape/media/list | Tape.Audit auf /tape (TapeAudit auf /tape); jeder Fehlschlag wird toleriert, ein PBS ohne Tape-Unterstützung eingeschlossen: keine Tape-Zeitreihe, kein Scrape-Fehler |
Beachten Sie, dass Audit auf /system allein nicht die
Update-Liste abdeckt, die PBS am Root-Pfad prüft. Ein 403 bei den
Job-Listen oder der Update-Liste wird als optionales Recht
behandelt: Nichts wird erzeugt und nichts in scrape_errors
gezählt. Und eine am Benutzer fehlende Rolle ist schlimmer als ein
403: Der Aufruf gelingt und gibt eine leere Liste zurück, daher wird
nichts erzeugt, und auch nichts beschwert sich.
Adresse: 10.0.0.20, pbs.lan, pbs.lan:8007, [fd00::2] oder
eine vollständige URL. Das Schema https und Port 8007 werden
hinzugefügt, falls fehlend.
Optionen
Abschnitt betitelt „Optionen“| Schlüssel | Label | Standard | Hilfe |
|---|---|---|---|
port | API port | 8007 | Genutzt, falls die Adresse keinen Port angibt. |
insecure_tls | Accept an unverifiable certificate | false | Proxmox Backup Server liefert standardmäßig ein selbstsigniertes Zertifikat: aktivieren Sie das, wenn die Verbindung deshalb abgelehnt wird. |
request_timeout_seconds | Timeout per request (seconds) | 15 | Erlaubte Zeit für jeden API-Aufruf, von 1 bis 120. Das Auflisten der Snapshots eines großen Datastores kann mehrere Sekunden dauern. |
task_lookback_hours | Task window (hours) | 24 | Ältere Tasks werden nicht unter den Fehlschlägen gezählt, von 1 bis 8760. |
datastores | Monitored datastores | (leer) | Namen der zu überwachenden Datastores, kommagetrennt. Leer: jeder Datastore. |
max_groups | Backup group limit | 500 | Maximale Anzahl Zeitreihen erzeugender gesicherter Maschinen; darüber hinaus werden die ältesten ignoriert. Von 1 bis 100000. |
jobs | Watch scheduled jobs | true | Listet die Sync-, Verify- und Prune-Jobs und ihren letzten Lauf (/admin/sync, /admin/verify, /admin/prune). |
updates | Watch pending updates | true | Zählt die Pakete mit verfügbarem Update (/nodes/localhost/apt/update). |
disks | Watch disks and ZFS pools | true | Liest die physischen Platten (SMART-Urteil, SSD-Verschleiß) und die ZFS-Pools (/nodes/localhost/disks). |
services | Watch the server’s services | true | Liest die systemd-Units und meldet, ob die, auf die der Server nicht verzichten kann, laufen. Braucht Sys.Audit auf /system; sonst still übersprungen. |
datastore_details | Read datastore detail | true | Zwei weitere Aufrufe pro Datastore: wie viele Maschinen und Snapshots er hält, was ihn gerade liest oder schreibt, und ob er zur Wartung gehalten wird. |
traffic_control | Watch traffic limits | true | Liest die Ratenlimits und was sie gerade tragen. Braucht Sys.Audit; sonst still übersprungen. |
certificates | Watch certificate expiry | false | Standardmäßig aus: PBS schützt diesen einen Aufruf mit Sys.Modify, einem Schreibrecht, das ein Monitoring-Token nicht haben sollte. |
tape | Watch tape backups | false | Liest die Tape-Stufe. Standardmäßig aus, da die meisten Installationen keine Tape-Hardware haben. Braucht Tape.Audit auf /tape. |
device_stale_days | Device staleness (days) | 3 | Eine gesicherte Maschine ohne neuen Snapshot länger als dies wird als veraltet gemeldet. Von 1 bis 90. |
Häufige Fehler
Abschnitt betitelt „Häufige Fehler“| Symptom | Wahrscheinliche Ursache |
|---|---|
| Zertifikatsfehler | Selbstsigniertes Zertifikat: installieren Sie ein vertrauenswürdiges (ACME ist in PBS eingebaut) oder aktivieren Sie insecure_tls. |
| Authentifizierungsfehler | Secret in Token ID eingefügt (oder umgekehrt), oder das Token hat keine Audit-Berechtigung — meist weil die Rolle dem Token, aber nicht dem es besitzenden Benutzer gewährt wurde, was nicht fehlschlägt: Die Aufrufe gelingen und geben leere Listen zurück. Nur ein fehlschlagendes GET /version verurteilt die gesamte Abfrage; jeder andere fehlschlagende Aufruf wird in scrape_errors gezählt. |
| Alles liest sich leer, aber der Monitor ist up | Dem Benutzer fehlt die ACL, die das Token hat, und PBS schneidet die beiden: proxmox-backup-manager user permissions 'dumbmonit@pbs!monitor' gibt nichts aus. Gewähren Sie jede Rolle auch dumbmonit@pbs. |
Keine node_updates_pending-Zeitreihe | Dem Token fehlt Sys.Audit auf /: Geben Sie ihm die Rolle Audit auf /, oder setzen Sie updates auf false, um nicht mehr zu fragen. |
| Ein Sync-Job fehlt | Dem Token fehlt Remote.Audit auf dem Remote des Jobs: Fügen Sie die Rolle RemoteAudit auf /remote hinzu. Der Job wird nicht abgelehnt, er fehlt einfach in der Liste. |
| Kein Zertifikatsablauf | Die Option certificates ist aus, was der Standard ist: PBS verlangt Sys.Modify für diesen Aufruf, ein Schreibrecht. |
| Das Tape-Panel erscheint nie | Die Option tape ist aus, was der Standard ist, oder der Server hat kein Laufwerk, keinen Wechsler, keinen Pool oder Tape-Job. Nichts wird veröffentlicht, wenn nichts da ist. |
| Keine Wachstumszahl auf einem Datastore | PBS’ Nutzungshistorie hat weniger als acht gemessene Punkte; sie füllt sich in den ersten Tagen. |
| “PBS datastore filling up” feuert nie | datastore_estimated_full_seconds wird von PBS aus einem Monat Messungen berechnet und fehlt bis dahin. |
| Fehlende Gruppen | Mehr als max_groups gesicherte Maschinen: backup_groups_dropped sagt, wie viele ausgelassen wurden. |
| Der Kalender ist leer oder kurz | Er füllt sich aus der Task-Liste bei der ersten Abfrage nach einem Start (letzte 30 Tage); ein PBS, dessen Task-Archiv bereinigt wurde, zeigt nur, was übrig ist. Eine Maschine, die nie auf diesem Server gesichert wurde und nie einen Task hatte, hat keine Zeile. |
Eine Maschine zeigt sich als vm/104 ohne ihren Namen | PVE schreibt den Gastnamen in die Snapshot-Notizen nur mit dem Standard-Notizen-Template ({{guestname}}); ein eigenes Template oder ein älteres PVE lässt die Notizen leer. |
| “Show log” schlägt fehl | Dem Token fehlt Sys.Audit auf /system für das Task-Log, oder PBS hat das Log eines alten Tasks schon rotiert. |