
Proxmox VE
Hipervisor: nós com os seus daemons e rede, máquinas virtuais, contentores, storages, thin pools LVM, cópias de segurança, alta disponibilidade, snapshots, replicação, Ceph até ao OSD, discos físicos e pools ZFS, atualizações pendentes, alterações de pacotes, subscrição e certificados. Um monitor pode cobrir um cluster inteiro.
O painel de nós
Seção intitulada “O painel de nós”A página do monitor abre com um cartão por nó: CPU, memória e sistema de
ficheiros raiz como três medidores, o tempo de atividade e a versão do
pve-manager instalada nesse nó, depois apenas o que está errado — os daemons que
não estão a correr, as interfaces declaradas no arranque que não estão ativas — e
a ocupação de cada thin pool LVM e grupo de volumes. Um nó que deixou de
responder mantém o seu cartão e lê-se offline.
Duas linhas sob os medidores, quando o nó as reporta: a parte do tempo de CPU passada à espera do armazenamento (I/O wait — um nó a 10 % de CPU e 30 % de I/O wait não tem folga nenhuma, e nenhum outro número o diz) e a memória que o KSM recuperou partilhando páginas idênticas entre convidados, que é como um nó aloja mais do que a sua RAM.
Mais duas entradas juntam-se à lista «o que está errado», ambas em palavras:
- Reboot required — está instalado um kernel mais recente do que o que
corre. O cartão nomeia ambas as versões, já que o nó continua a correr a antiga
até ser reiniciado. Vem de
/nodes/{node}/apt/versions, que só precisa deSys.Audit; - Updates pending — quantos pacotes Proxmox têm uma versão candidata mais
recente, da mesma chamada. Não é o mesmo que
apt/update, que conta todos os pacotes pendentes do sistema mas precisa deSys.Modifye é normalmente recusado.
Quando o cluster reporta um watchdog de HA (Proxmox VE 9 e posteriores), o seu estado é indicado ao lado do título do painel: HA fencing armed quando há recursos entregues ao HA, HA fencing standby enquanto não há — caso em que nenhum nó será isolado (fenced), o que é normal mas convém saber antes de contar com isso.
Um cluster atualizado nó a nó mostra-o aqui: /version responde pelo nó
consultado, pelo que cada cartão traz a sua própria versão e um atrasado fica
visível sem abrir uma shell.
Os dados vêm de GET /api/targets/{id}/proxmox/nodes, lidos da última sonda no
armazenamento de métricas.
O painel de convidados
Seção intitulada “O painel de convidados”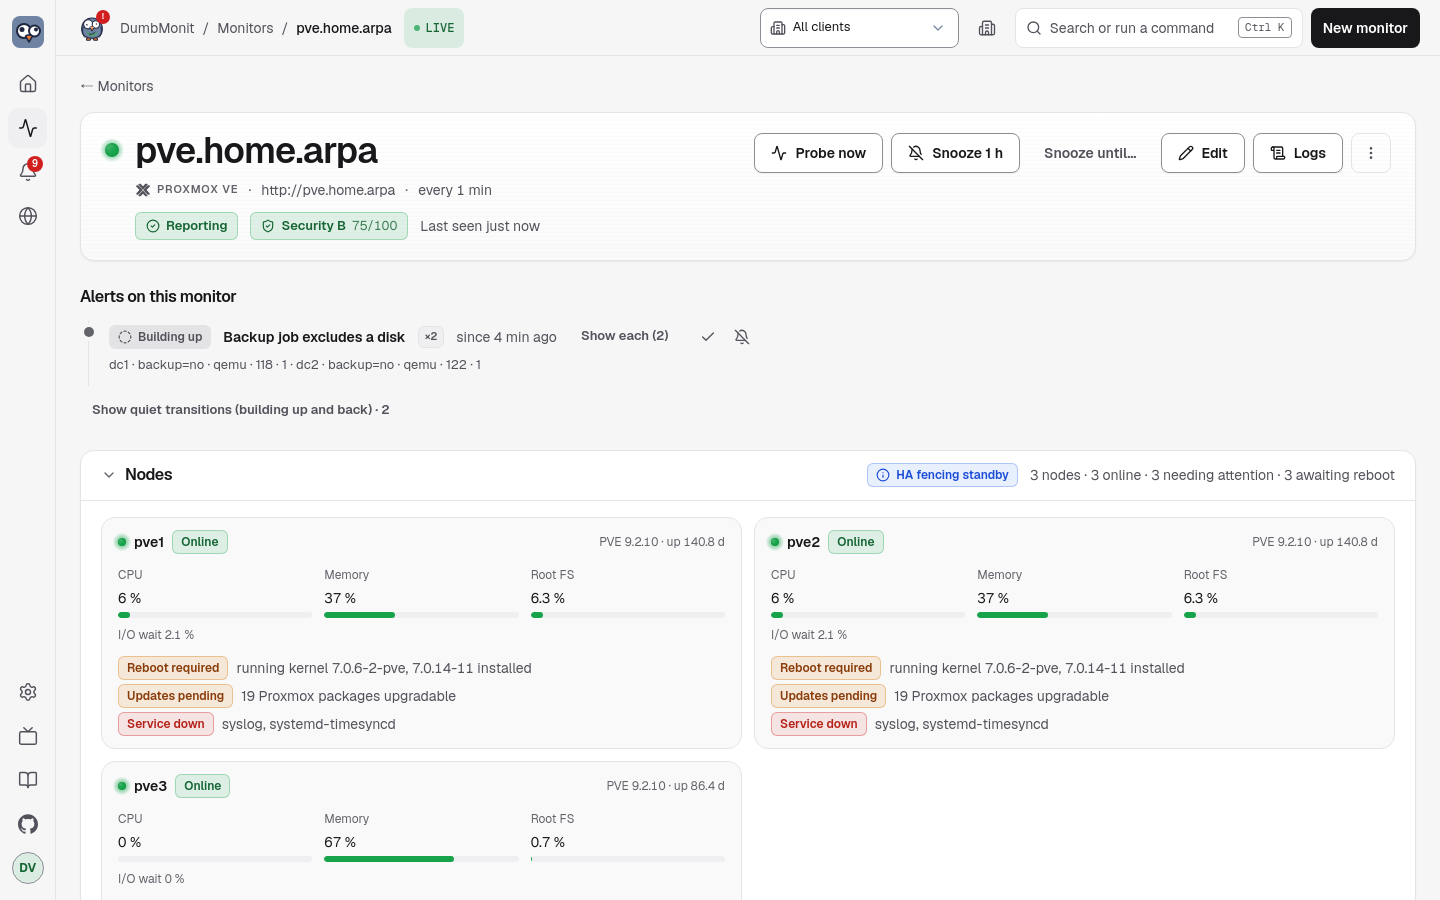
Abaixo dos nós, o painel Guests: uma linha por máquina virtual e contentor, agrupadas por nó, que responde às perguntas que um administrador faz primeiro — está a correr, está ocupado, o disco está cheio, quando teve a última cópia de segurança. Cada linha mostra:
| Coluna | Origem | Notas |
|---|---|---|
| Estado | palavra + placa: running, stopped, paused, suspended, template | Um modelo é listado mas nunca conta como «stopped». |
| Nome, VMID, nó | o inventário | |
| CPU | guest_cpu_percent, dos núcleos atribuídos ao convidado | Uma barra mais o número de núcleos. |
| Memória | guest_memory_used_bytes / guest_memory_total_bytes | O tamanho do balloon quando a VM tem um. Uma segunda linha, +N on host, aparece quando guest_memory_host_bytes está significativamente acima do que o convidado vê: um processo QEMU custa ao hipervisor mais do que a memória que entrega, e esse excedente é a sobrecarga de emulação. Abaixo de 64 MiB ou 5 % a linha não aparece. |
| Disco | guest_disk_used_bytes / guest_disk_total_bytes | Contentores: uso real. VM: tamanho sempre; uso apenas quando o agente de convidado QEMU responde (veja abaixo), caso contrário «size only». |
| Rede | rate(guest_network_in/out_bytes) nas últimas sondas | |
| Tempo de atividade | guest_uptime_seconds | |
| Última cópia de segurança | backup_last_age_seconds | Vazio quando não se conhece nenhuma cópia. |
| HA | ha_resource_state_info | Apenas para convidados sob alta disponibilidade. |
| Lock | guest_locked | Um distintivo, apenas enquanto um bloqueio é mantido (backup, migrate, snapshot…). |
A lista ordena-se por qualquer coluna, filtra-se por nó, estado ou pool, e cada
grupo de nó dobra-se. Clicar numa linha abre o seu CPU e memória no intervalo de
tempo da página, juntamente com o sistema operativo e os endereços IP vistos de
dentro do convidado. Os dados vêm de GET /api/targets/{id}/proxmox/guests, que
lê a última sonda do armazenamento de métricas — nada é pedido ao hipervisor.
Um bloqueio é normal durante os poucos minutos que uma cópia de segurança, uma
migração ou um snapshot demoram. Deixado para trás por uma tarefa interrompida,
bloqueia todas as operações nesse convidado — incluindo a cópia de segurança da
noite seguinte — até qm unlock (ou pct unlock) o limpar, razão pela qual
«Guest locked» dispara ao fim de seis horas.
O inventário vem de /cluster/resources, a própria cache do cluster, pelo que os
convidados de um nó que deixou de responder continuam listados — com o estado
unknown e os seus tamanhos, sem medições em tempo real — em vez de desaparecerem
do painel no momento em que os quer ver. Custa também duas chamadas de API a menos
por nó do que percorrer /nodes/{node}/qemu e /nodes/{node}/lxc, que é o que a
opção cluster_resources faz quando desativada.
Uso de disco dentro de uma VM: o agente de convidado QEMU
Seção intitulada “Uso de disco dentro de uma VM: o agente de convidado QEMU”O Proxmox vê o disco de uma VM como um volume opaco: disk é sempre 0 para uma
VM, só o seu tamanho é conhecido. Para ler o uso por dentro, o coletor pergunta
ao agente de convidado QEMU (agent/get-fsinfo) para cada VM em execução cuja
configuração ativa o agente (Options → QEMU Guest Agent). Duas condições:
qemu-guest-agentinstalado e a correr dentro da VM (Debian e Ubuntu:apt install qemu-guest-agent; Windows: a ISO de drivers VirtIO);- o token tem
VM.GuestAgent.Auditna VM —VM.Monitorantes do Proxmox VE 9 (o papelDumbMonitabaixo concede-o em/).
O sistema de ficheiros raiz (/, ou C:\ no Windows; na falta, o maior) dá
guest_disk_used_bytes e guest_disk_used_percent, as mesmas séries que um
contentor tem, pelo que a regra «VM or container disk almost full» cobre
ambos. Cada sistema de ficheiros real recebe também guest_fs_total/used_bytes e
guest_fs_used_percent com uma etiqueta mountpoint; os sistemas de ficheiros
pseudo (tmpfs, squashfs, montagens snap) e os suportes sem capacidade são
ignorados. guest_agent_enabled diz se a configuração da VM ativa o agente,
guest_agent_running se ele respondeu. Sem o agente ou o direito, a VM mantém o
seu tamanho e simplesmente não tem uso — nunca um «0 %» enganador.
O sistema operativo e os endereços de um convidado
Seção intitulada “O sistema operativo e os endereços de um convidado”O Proxmox só conhece o tipo de SO escrito na configuração de um convidado (l26,
win11), não o que realmente corre. Com a opção guest_os ativada, o coletor
pergunta a cada convidado em execução o que é: agent/get-osinfo e
agent/network-get-interfaces para uma VM, /nodes/{node}/lxc/{vmid}/interfaces
para um contentor, que não precisa de nada instalado no interior. Isso dá
guest_os_info (Debian GNU/Linux 12 (bookworm), o seu id, a sua versão, o
kernel) e até quatro guest_ip_info — os endereços loopback e IPv6 link-local
são ignorados, e uma máquina com dezenas de interfaces virtuais não enche a base
de dados de séries.
Ambos são pedidos no máximo uma vez por hora por convidado e republicados a partir da memória entretanto: um sistema operativo não muda entre duas sondas, e um endereço quase nunca. Num cluster de cinquenta máquinas em execução é a diferença entre duas chamadas extra por sonda e duas por hora.
Essas duas chamadas de agente precisam de VM.GuestAgent.Audit. O Proxmox VE 7 não
o tinha e usava VM.Monitor; o Proxmox VE 9 removeu VM.Monitor e mantém apenas
os privilégios de agente de convidado. Sem o que a sua versão conhece, as duas
séries ficam simplesmente ausentes; nada mais muda.
O painel Ceph
Seção intitulada “O painel Ceph”Uma secção Ceph aparece na página do monitor apenas quando o cluster tem realmente Ceph: saúde e as palavras por detrás dela, capacidade total e usada, quantos OSD estão up e in, uma tabela de OSD (anfitrião, classe de dispositivo, uso, latência de apply e commit) e uma tabela de pools (uso, size e min size, placement groups contra o número que o autoscaler escolheria), os sistemas de ficheiros CephFS, as flags de OSD deixadas definidas e as verificações de saúde atualmente silenciadas.
Estas duas últimas são as que um dashboard costuma esconder. Um noout definido
para uma manutenção e nunca limpo significa que o Ceph não voltará a reequilibrar
um OSD morto, e uma verificação silenciada já não aparece em HEALTH_OK — nos dois
casos o cluster parece saudável enquanto a sua redundância desaparece
silenciosamente.
GET /api/targets/{id}/proxmox/ceph responde available: false quando o cluster
não tem Ceph, que é como a interface sabe que não deve desenhar a secção. O
detalhe custa três chamadas num único nó mais duas a nível do cluster, seja qual
for o tamanho do cluster, e precisa da opção ceph_detail além de ceph.
O que monitoriza
Seção intitulada “O que monitoriza”Todas as métricas têm o prefixo dumbmonit_proxmox_.
| Família | Métricas | Etiquetas |
|---|---|---|
| Cluster | cluster_quorate, cluster_nodes, cluster_nodes_online, cluster_member_online; version_info (+ version, release, repoid) | cluster, node |
| Inventário do cluster | cluster_guests_total, cluster_guests_running, cluster_templates_total (modelos contados à parte, nunca como «stopped»); pool_guests, um por resource pool | pool |
| Nós | node_up, node_cpu_percent, node_cpu_count, node_load1/5/15, node_memory_used/total_bytes, node_memory_percent, node_swap_used/total_bytes, node_rootfs_used/total/avail_bytes, node_rootfs_percent, node_cpu_iowait_percent (tempo passado à espera dos discos — um nó a 10% de CPU e 30% de iowait não tem folga), node_ksm_shared_bytes (memória recuperada por deduplicação de páginas), node_uptime_seconds, node_version_info | node |
| Serviços do nó | node_service_running, node_service_state_info (+ state), node_services_failed, node_core_services_down; node_pve_version_info (+ version, release) para o nó que respondeu | node, service |
| Rede do nó | node_interface_active, node_interface_exists, node_interface_autostart, node_interface_mtu, node_interface_offline; total node_interfaces_offline | node, iface, type (bridge, bond, vlan, eth…) |
| LVM, thin pools e montagens | node_lvm_vg_size/free_bytes, node_lvm_vg_used_percent, node_lvm_vg_physical_volumes (etiqueta vg); node_thinpool_size_bytes, node_thinpool_used_bytes, node_thinpool_used_percent, node_thinpool_metadata_size_bytes, node_thinpool_metadata_used_percent (etiquetas vg, pool); node_directory_mount_info (+ path, device, fstype), node_directory_mounts | node, vg, pool |
| Convidados (VM e contentores) | guest_status_info (+ status: running, stopped, paused, suspended, template), guest_running (não para modelos), guest_cpu_percent (dos núcleos atribuídos), guest_cpu_count, guest_memory_used/total_bytes, guest_memory_host_bytes (Proxmox VE 9: a memória que a VM ocupa no anfitrião, sobrecarga de emulação incluída), guest_memory_percent (do ponto de vista do próprio convidado; no Proxmox VE 9 vem do driver balloon, e uma VM sem um tem bytes mas não percentagem, em vez de um valor acima de 100%), guest_disk_total_bytes, guest_disk_used_bytes e guest_disk_used_percent (contentores; VM apenas através do agente de convidado), guest_disk_read/write_bytes, guest_network_in/out_bytes (contadores), guest_uptime_seconds; guest_pool_info (+ pool), guest_locked (+ lock; a série só existe enquanto o bloqueio é mantido, pelo que a sua duração se lê diretamente do gráfico) | node, vmid, name, type (qemu ou lxc) |
| Detalhe de VM (VM em execução) | guest_agent_enabled, guest_agent_running, guest_balloon_bytes, guest_memory_guest_free_bytes (memória livre vista de dentro, driver balloon), guest_running_qemu_info (+ version: o QEMU com que a VM foi iniciada — após uma atualização do hipervisor fica para trás até a VM ser parada e iniciada de novo, o que uma migração em direto não faz); por sistema de ficheiros guest_fs_total_bytes, guest_fs_used_bytes, guest_fs_used_percent | node, vmid, name, type; sistemas de ficheiros: + mountpoint, fstype |
| Sistema e endereços do convidado | guest_os_info (+ os, os_id, os_version, kernel), guest_ip_info (+ iface, ip; no máximo quatro endereços encaminháveis por convidado). Atualizado uma vez por hora | node, vmid, name, type |
| Placas de rede do convidado | guest_netdev_in_bytes, guest_netdev_out_bytes (contadores), um par por interface virtual onde guest_network_in/out_bytes só dá o total do convidado | node, vmid, dev (tap100i0, veth200i0) |
| Storages | storage_active, storage_enabled, storage_used/total/avail_bytes, storage_used_percent (a capacidade só é publicada quando o Proxmox a reporta: um storage inativo, ou um datastore PBS cujo tamanho o PVE não lê, não recebe nenhuma em vez de zero bytes) | node, storage, type (dir, lvmthin, zfspool, nfs, pbs…), shared |
| Cópias de segurança (por convidado) | backup_present, backup_last_timestamp_seconds, backup_last_age_seconds, backup_last_size_bytes, backup_count; totais backup_guests_total, backup_guests_without_backup | vmid, name, node, type |
| Cópias de segurança (execuções vzdump, por nó) | backup_job_runs, backup_job_failures, backup_job_last_ok, backup_job_last_timestamp_seconds, backup_job_last_age_seconds, backup_job_last_duration_seconds | node |
| Tarefas de cópia de segurança (agendadas) | backup_job_enabled, backup_job_next_run_seconds, backup_job_last_ok, backup_job_last_run_age_seconds (as duas últimas apenas quando uma tarefa vzdump traz o id da tarefa, PVE 7.2+); totais backup_jobs_total, backup_guests_not_covered; backup_covered por convidado (0 para um convidado que nenhuma tarefa cobre) | job, storage, schedule; backup_covered: vmid, name, node, type |
| Cobertura das tarefas de cópia de segurança | backup_job_guests, backup_job_volumes_included, backup_job_volumes_excluded; backup_job_guest_excluded_volumes (+ vmid, name, type, reason), publicada apenas para uma exclusão inesperada | job |
| HA | ha_quorum_ok, ha_fencing_armed (+ state: o Proxmox VE 9 reporta se o watchdog está armed ou em standby — em standby nada será isolado), ha_master_active, ha_lrm_active (node), ha_resources_total; por recurso ha_resource_started, ha_resource_error (1 no estado error, fence ou recovery), ha_resource_state_info (+ state) | sid, node, vmid, type |
| Gestor de HA | ha_node_online, ha_node_status_info (+ status: online, fence, gone, maintenance), ha_master_info (o nó que detém o CRM master), ha_manager_age_seconds; por nó ha_lrm_mode_info (+ mode, state), ha_lrm_age_seconds, ha_lrm_stale (1 quando o LRM não escreve há mais de dois minutos) | node |
| Snapshots | guest_snapshot_count, guest_snapshot_oldest_age_seconds, guest_snapshot_newest_age_seconds (idades apenas quando count > 0); guest_snapshot_guests_skipped quando max_snapshot_guests é excedido | vmid, name, node, type |
| Replicação | replication_job_enabled, replication_job_error (mensagem de erro ou fail_count > 0), replication_job_fail_count, replication_job_last_sync_age_seconds, replication_job_next_sync_seconds, replication_job_duration_seconds; replication_jobs_total | job, vmid, node (origem), to_node |
| Ceph | ceph_health (0 OK, 1 WARN, 2 ERR, 3 desconhecido), ceph_health_info (+ status), ceph_osds_total/up/in, ceph_bytes_total/used, ceph_used_percent, ceph_pgs_total, ceph_mons_total | |
| OSD do Ceph | ceph_osd_up, ceph_osd_in, ceph_osd_used_percent, ceph_osd_used_bytes, ceph_osd_total_bytes, ceph_osd_apply_latency_ms, ceph_osd_commit_latency_ms, ceph_osd_reweight, ceph_osd_crush_weight; totais ceph_osds_down, ceph_osds_out | osd, ceph_host, device_class |
| Pools Ceph e CephFS | ceph_pool_used_percent, ceph_pool_used_bytes, ceph_pool_size, ceph_pool_min_size, ceph_pool_pg_num, ceph_pool_pg_num_optimal (o que o autoscaler escolheria), ceph_pool_info (+ type, crush_rule, autoscale), ceph_pools_total; ceph_fs_info (+ metadata_pool, data_pool), ceph_fs_total | pool; CephFS: name |
| Flags e silenciamentos do Ceph | ceph_flag (1 enquanto a flag está definida), ceph_flags_set; ceph_health_mute_info (+ sticky), ceph_health_mutes | flag; silenciamentos: code |
| Discos físicos | node_disk_size_bytes, node_disk_smart_failed (1 quando a saúde SMART é FAILED; ausente quando o disco reporta UNKNOWN), node_disk_health_info (+ health, used: LVM, ZFS, partitions…), node_disk_wearout_percent (SSD e NVMe: 0 novo, 100 fim da vida nominal), node_disk_temperature_celsius (de disks/smart: atributo ATA 194/190, ou a linha de temperatura de um relatório de texto — Temperature: para NVMe, Current Drive Temperature: para SAS) | node, disk (/dev/sda, /dev/nvme0n1), model, type (ssd, hdd, nvme) |
| Pools ZFS | node_zfs_pool_degraded (1 a menos que ONLINE), node_zfs_pool_health_info (+ health), node_zfs_pool_size/alloc/free_bytes, node_zfs_pool_used_percent, node_zfs_pool_fragmentation_percent | node, pool |
| Atualizações | node_updates_pending, node_updates_security_pending (pacotes cuja origem, etiqueta de repositório, suite, secção ou URL de changelog nomeia um arquivo de segurança, como o bookworm-security do Debian). Sem Sys.Modify estas duas não existem; node_pve_packages_upgradable conta então ainda os pacotes Proxmox cuja versão candidata difere da instalada, e node_reboot_required (+ running, installed) diz que um kernel mais recente está instalado mas ainda não arrancado — ambos lidos de apt/versions, que só precisa de Sys.Audit | node |
| Alterações de pacotes | node_packages_changed: 0 normalmente; durante uma hora depois de uma sonda ver mudar a versão instalada de um pacote Proxmox (apt/versions), o número de pacotes que mudaram, com uma etiqueta changes como pve-manager 8.2.4→8.2.7, proxmox-kernel-6.8 6.8.8-2→6.8.12-2 | node, changes |
| Subscrição e repositórios | node_subscription_active, node_subscription_info (+ status: active, notfound, expired…, level, next_due); node_repository_errors (ficheiros de fontes ilegíveis), node_repository_warnings (os avisos do próprio Proxmox: repositório enterprise sem subscrição, repositório de teste), node_repository_enabled (+ repo: enterprise, no-subscription, test, ceph-*) | node |
| Certificados | node_certificate_expiry_days (negativo depois de expirado) | node, filename, subject |
| Stream RRD (desativado por predefinição) | node_rrd_<metric>, guest_rrd_<metric>, storage_rrd_<metric> — todas as medições que os próprios servidores de métricas do Proxmox recebem, sob o seu próprio nome (veja metrics_export abaixo) | node; convidados: vmid, type; storages: node, storage |
| Recolha | up, scrape_errors, scrape_duration_seconds |
A idade da cópia de segurança por máquina responde à falha mais cara de um
homelab: a cópia de segurança que não corre há semanas, descoberta no dia do
restauro. É calculada a partir do registo de tarefas vzdump (ao longo de
backup_lookback_days) e, se scan_backup_storage estiver ativado, a partir dos
arquivos encontrados nos storages de cópias de segurança.
As tarefas agendadas vêm de Datacenter → Backup: backup_covered é 0 para todos
os convidados que o próprio Proxmox lista como não cobertos por nenhuma tarefa,
pelo que uma máquina criada ontem aparece antes da sua primeira cópia de
segurança falhada e não depois.
Uma tarefa que cobre um convidado não escreve necessariamente todos os seus
discos. Um volume marcado backup=0 é ignorado todas as noites, a tarefa
continua a reportar êxito, e ninguém descobre até um restauro.
backup_job_guest_excluded_volumes nomeia a tarefa, o convidado e o motivo do
próprio Proxmox para a exclusão — mas só quando a exclusão é uma surpresa: uma
unidade de CD-ROM, uma imagem cloudinit ou uma entrada que nem sequer é um
volume é excluída por conceção, contada em backup_job_volumes_excluded e nunca
reportada por convidado. Sem essa distinção, cada máquina com uma unidade virtual
levantaria um alerta.
Os daemons de um nó merecem ser vigiados por uma razão: um pvestatd parado não
quebra nada visivelmente — a interface web continua a mostrar os números do
momento em que morreu, e tudo parece normal. node_core_services_down conta
apenas pve-cluster, pvedaemon, pveproxy, pvestatd, pve-firewall,
corosync e watchdog-mux, e apenas aqueles que o próprio nó declara como
ativados, pelo que um nó autónomo sem corosync nem HA não conta nada em falta.
Uma interface conta como offline quando está definida para arrancar no arranque e não está ativa (ou já nem existe). Uma levantada a pedido, sem autostart, nunca é reportada: a sua ausência é normal. Uma bridge que não volta após um reinício isola todos os convidados ligados a ela enquanto cada um desses convidados corre perfeitamente, e nada mais o diz.
Um thin pool LVM que enche coloca todos os convidados nele armazenados em só leitura de uma vez, e apagar ficheiros dentro dos convidados não devolve o espaço. Os seus metadados vivem num volume próprio, muito mais pequeno, e saturam muitas vezes primeiro, com exatamente a mesma consequência — razão pela qual os dois níveis de ocupação são séries separadas e regras separadas.
As alterações de pacotes são detetadas pelo próprio coletor: lembra as versões instaladas da sonda anterior (por monitor e nó, em memória — um reinício do servidor aprende de novo sem reportar). Só conta um pacote presente em ambas as sondas com uma versão diferente; um pacote recém-instalado ou removido não conta.
Uma falha parcial (um nó em baixo, um storage lento) continua a ser uma sonda
bem-sucedida: o que pôde ser lido é escrito e a falha é contada em
scrape_errors. As funcionalidades simplesmente ausentes ficam em silêncio: sem
Ceph, sem tarefa de replicação, sem pool ZFS, sem agente de convidado, ou sem
direito a listar atualizações não produzem séries nem erro. O mesmo vale para
tudo o que está acima: um privilégio em falta (403), um endpoint que um Proxmox
mais antigo não tem (404 ou 501), uma funcionalidade que não está instalada (o
Ceph responde 500) não produzem erro nem métrica nenhuma — nunca um zero a fingir
ser uma medição.
As temperaturas de placa não estão disponíveis: a API do Proxmox VE não expõe sensores, apenas a temperatura SMART dos próprios discos. Instale o agente DumbMonit no nó se precisar de mais.
Regras incorporadas que se aplicam: Monitor unreachable, High CPU, Disk almost full, Filesystem almost full (forecast), Backup too old, Unusual CPU, VM or container stopped, VM or container CPU high, VM or container memory high, VM or container disk almost full, HA resource in error, Cluster lost quorum, Node offline, Storage almost full, Backup job failed, Old snapshot, Replication failed, Ceph health error, Ceph health warning, Updates pending, Security updates pending, Proxmox packages changed, Proxmox disk wearing out, Proxmox disk SMART failure, Proxmox ZFS pool degraded, Node certificate expiring, Thin pool almost full, Thin pool metadata almost full, Proxmox service down, Node network interface down, Ceph OSD down, Ceph OSD nearly full, Ceph pool almost full, Ceph noout flag left on, HA manager not reporting, Backup job excludes a disk, Guest locked.
O stream RRD completo
Seção intitulada “O stream RRD completo”/cluster/metrics/export é o endpoint que os próprios servidores de métricas do
Proxmox (InfluxDB, Graphite) consomem: tudo o que o pvestatd mede, para todo o
cluster, numa só chamada. Duas coisas fazem com que valha a pena tê-lo.
- Traz medições que mais nada expõe — em particular a informação de pressure stall (PSI) por nó: quanto tempo as tarefas passam à espera do CPU, do disco ou da memória. É o número que explica «está tudo lento» quando CPU e memória parecem ambos bem.
- É lido com
history=1a partir do último ponto já visto, pelo que cada ponto entre duas sondas é ingerido com o seu próprio carimbo temporal. Um monitor sondado de cinco em cinco minutos recebe os seus cinco pontos de um minuto em vez de um único valor atual.
Está desativado por predefinição, e é uma troca deliberada. Estas séries
repetem em parte outras que o resto da recolha já produz com melhores nomes, pelo
que ativar metrics_export acrescenta um grande número de séries a armazenar e a
vasculhar por um detalhe que a maioria das instalações nunca consulta. Os nomes
são publicados exatamente como o Proxmox os envia (node_rrd_pressure_cpu_some_avg10,
guest_rrd_netin…) em vez de traduzidos: o Proxmox acrescenta novos em cada
versão, e uma tabela de tradução escrita aqui estaria errada na seguinte. Precisa
de Sys.Audit em / — que o papel DumbMonit já tem quando foi concedido em /
como abaixo.
O que preparar no Proxmox
Seção intitulada “O que preparar no Proxmox”Os passos abaixo são os que o aviso junto ao formulário mostra. O princípio: um utilizador reservado à monitorização, um papel que só pode ler, um token — nunca a conta com que inicia sessão.
-
Abra uma shell em qualquer nó (na interface web: selecione o nó, depois Shell; ou SSH) e crie um utilizador reservado à monitorização. Não precisa de palavra-passe: é o token que inicia sessão.
pveum user add dumbmonit@pve --comment "DumbMonit monitoring" -
Crie um papel só com os privilégios que o coletor usa: Sys.Audit (nós, cluster, HA, discos e SMART, ZFS, certificados, versões de pacotes, subscrição), Datastore.Audit (storages e arquivos de cópias de segurança), VM.Audit (VM, contentores, snapshots) e VM.GuestAgent.Audit (o que o agente de convidado QEMU lê dentro de uma VM: uso de disco, sistema operativo, endereços IP). Nenhum deles pode alterar nada.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.GuestAgent.Audit" -
Dê ao utilizador esse papel em todo o cluster.
pveum aclmod / -user dumbmonit@pve -role DumbMonit -
Crie o token de API do utilizador. A separação de privilégios está desativada, pelo que o token herda simplesmente os direitos do utilizador.
pveum user token add dumbmonit@pve monitor --privsep 0 -
O comando imprime uma tabela com full-tokenid e value. Copie full-tokenid para o campo Token ID do DumbMonit e value (o UUID) para o seu campo Secret. O segredo é mostrado uma vez: se se perder, remova o token e crie um novo.
dumbmonit@pve!monitor -
Opcional, para contar as atualizações pendentes e as correções de segurança pendentes: o Proxmox guarda essa lista com Sys.Modify. Conceda-o apenas em /nodes; sem ele o coletor ignora a lista em silêncio.
pveum role add DumbMonitUpdates --privs Sys.Modifypveum aclmod /nodes -user dumbmonit@pve -role DumbMonitUpdates -
Num Proxmox mais antigo, VM.GuestAgent.Audit pode ainda não existir e o comando acima é recusado com invalid privilege: as chamadas ao agente de convidado são então cobertas por VM.Monitor, que o Proxmox VE 9 por sua vez removeu. Use o que a sua versão conhece.
pveum role add DumbMonit --privs "Datastore.Audit Sys.Audit VM.Audit VM.Monitor" -
Prefere a interface web? Os mesmos passos estão em Datacenter → Permissions: Users, Roles, Add → User Permission, depois API Tokens com «Privilege Separation» desmarcado.
-
No DumbMonit, introduza o endereço de qualquer nó (porta 8006 por predefinição).
Documentação do fabricante: Proxmox VE user management.
Credenciais
Seção intitulada “Credenciais”| Credencial | Campos |
|---|---|
| Token de API (recomendado) | Token ID: utilizador, realm e nome do token como o Proxmox os mostra, dumbmonit@pve!monitor. Secret: o UUID mostrado uma vez quando o token foi criado. Sem expiração, sem sessão aberta no hipervisor. |
| Nome de utilizador / palavra-passe | user@realm e a palavra-passe. Um ticket é obtido, guardado em cache e renovado dez minutos antes da sua expiração de duas horas. |
A API aceita o token em duas partes (token_id + secret) ou, como as versões
anteriores faziam, como uma única cadeia token = user@realm!name=secret; ambos
são guardados da mesma forma. Um token inteiro colado em Token ID é dividido pelo
formulário.
O papel DumbMonit acima traz o que o PVEAuditor concede para os caminhos que o
coletor lê, mais o privilégio de agente de convidado: o coletor só faz GET. Por
endpoint: Sys.Audit para /version, /cluster/*, /nodes/{node}/status,
services, version, network, netstat, tasks, replication,
certificates/info, disks/list, disks/smart, disks/zfs, apt/versions,
apt/repositories e subscription; Datastore.Audit para storage e
storage/{id}/content; VM.Audit para qemu, lxc, snapshot,
status/current e as interfaces de um contentor; VM.GuestAgent.Audit — ou
VM.Monitor antes do Proxmox VE 9 — para agent/get-fsinfo.
Dois caminhos pedem um pouco mais do que os restantes, e ambos são cobertos pelo
papel tal como concedido no passo 3 — em /, não em /nodes:
Sys.Auditem/para o inventário LVM (disks/lvm,disks/lvmthin,disks/directory) e para/cluster/metrics/export, o stream RRD opcional. Concedido apenas em/nodes, as séries de thin pools e as séries*_rrd_*ficam silenciosamente ausentes.VM.GuestAgent.Auditpara as duas chamadas de agente de convidado que leem o sistema operativo e os endereços de uma VM (agent/get-osinfo,agent/network-get-interfaces). O Proxmox VE 7 não tinha esse privilégio e usavaVM.Monitor; o Proxmox VE 9 eliminouVM.Monitor. Sem o que a sua versão conhece,guest_os_infoeguest_ip_infosimplesmente não são publicados para VM; os contentores, que não precisam de agente, mantêm os seus endereços.
A única coisa que o papel não cobre de todo é a lista de atualizações pendentes
(apt/update), que o Proxmox guarda com Sys.Modify em /nodes — opcional, como
o passo 6 explica; sem ele o coletor ignora node_updates_pending e
node_updates_security_pending em silêncio.
(Use -token 'dumbmonit@pve!monitor' em vez de -user nos comandos aclmod para
um token criado com «Privilege Separation» marcado.)
Endereço: 10.0.0.10, pve.lan, pve.lan:8006, [fd00::1] ou um URL completo
https://pve.example.net. O esquema https e a porta 8006 são acrescentados se
faltarem.
| Chave | Rótulo | Predefinição | Ajuda |
|---|---|---|---|
port | Porta da API | 8006 | Usada se o endereço não indicar porta. |
insecure_tls | Aceitar um certificado não verificável | false | O Proxmox traz por predefinição um certificado autoassinado: ative-a se a ligação for recusada por esse motivo. |
request_timeout_seconds | Tempo limite por pedido (segundos) | 10 | Tempo permitido para cada chamada à API, de 1 a 120. |
backup_lookback_days | Retrospetiva de cópias de segurança (dias) | 31 | As tarefas de cópia de segurança mais antigas não são examinadas, de 1 a 3650. |
scan_backup_storage | Inventariar arquivos de cópias de segurança | true | Percorre os storages de cópias de segurança para datar a última cópia de cada máquina. Desative se o storage demorar a responder. |
nodes | Nós monitorizados | (vazio) | Nomes dos nós a monitorizar, separados por vírgulas. Vazio: todos os nós do cluster. |
cluster_resources | Ler o inventário do cluster | true | Uma chamada a /cluster/resources lista todos os nós, convidados, storages e pools. Mantenha-a ativada: é a única origem que ainda vê os convidados de um nó que deixou de responder, e poupa duas chamadas por nó. Desativada, o coletor percorre antes /nodes/{node}/qemu e /nodes/{node}/lxc, e perde os pools e os bloqueios. |
services | Vigiar serviços do nó | true | /nodes/{node}/services e version: o estado dos daemons Proxmox de cada nó e a versão nele instalada. Um pvestatd parado deixa todo o cluster a mostrar números congelados. |
network | Vigiar a rede do nó | true | /nodes/{node}/network e netstat: bridges, bonds e VLAN com o seu estado de ligação, mais os contadores de tráfego da placa de rede de cada convidado. |
lvm | Vigiar LVM e thin pools | true | disks/lvm, disks/lvmthin e disks/directory: grupos de volumes, thin pools (ocupação de dados e de metadados) e montagens de diretoria geridas pelo PVE. Precisa de Sys.Audit em /; silencioso caso contrário. |
ha | Alta disponibilidade | true | Lê /cluster/ha/status/current e manager_status: quórum, CRM master, a vista do próprio gestor de cada nó, cada LRM com a idade do seu último relatório, e cada recurso HA. |
backup_jobs | Tarefas de cópia de segurança agendadas | true | Lê as tarefas de Datacenter → Backup e os convidados que nenhuma tarefa cobre. |
scan_snapshots | Inventariar snapshots | true | Uma chamada por convidado (quatro em simultâneo por nó). Desative em clusters muito grandes. |
max_snapshot_guests | Limite do inventário de snapshots | 200 | Os convidados além deste número são ignorados em cada sonda e contados em guest_snapshot_guests_skipped, de 1 a 10000. |
replication | Tarefas de replicação | true | Estado da replicação de storage por nó. Silencioso quando o nó não tem tarefa. |
ceph | Saúde do Ceph | true | Lê /cluster/ceph/status. Silencioso quando o Ceph não está instalado. |
ceph_detail | Vigiar o Ceph em detalhe | true | Estado, uso e latência por OSD, uso por pool, CephFS, flags de OSD e verificações de saúde silenciadas. Três chamadas num nó mais duas a nível do cluster, seja qual for o tamanho do cluster. Precisa de ceph ativado; silencioso sem Ceph. |
backup_volumes | Verificar o que as tarefas de cópia de segurança incluem | true | Para cada tarefa agendada, que convidados cobre e quais dos seus discos escreve realmente. Apanha uma tarefa que tem êxito todas as noites enquanto ignora um disco de dados. Uma chamada por tarefa. |
guest_os | Ler SO e endereços do convidado | true | Sistema operativo e endereços IP vistos de dentro de cada convidado em execução (agente de convidado QEMU para VM, o namespace do contentor para contentores). Atualizado uma vez por hora por convidado, não em cada sonda. Precisa de VM.GuestAgent.Audit no Proxmox VE 8. |
metrics_export | Ingerir o stream completo de métricas RRD | false | Lê /cluster/metrics/export, o stream que os próprios servidores de métricas do Proxmox consomem, incluindo o pressure stall (PSI) por nó, e todos os pontos desde a última sonda e não apenas o atual. Desativado por predefinição: as séries *_rrd_* que acrescenta repetem em parte as já recolhidas. Precisa de Sys.Audit em /. |
updates | Atualizações pendentes | true | Conta os pacotes que apt/update lista. Precisa de Sys.Modify em /nodes (veja acima); silencioso caso contrário. |
certificates | Expiração de certificados | true | Dias restantes em cada certificado do nó (pve-ssl.pem, pveproxy-ssl.pem, pve-root-ca.pem). |
guest_agent | Perguntar ao agente de convidado QEMU | true | Para cada VM em execução: status/current (balloon, flag do agente) e, quando o agente está ativado, agent/get-fsinfo (precisa de VM.GuestAgent.Audit). Quatro chamadas em simultâneo por nó. Silencioso quando o agente está ausente. |
disks | Vigiar discos físicos | true | disks/list mais uma chamada disks/smart por disco: saúde, desgaste, temperatura. |
zfs | Vigiar pools ZFS | true | disks/zfs: saúde, capacidade, fragmentação. Silencioso sem ZFS. |
packages | Detetar alterações de pacotes | true | apt/versions comparado com a sonda anterior; uma alteração é reportada durante uma hora em node_packages_changed. |
subscription | Vigiar subscrição e repositórios | true | subscription e apt/repositories: estado, avisos, repositórios standard ativados. |
Erros comuns
Seção intitulada “Erros comuns”| Sintoma | Causa provável |
|---|---|
| Erro de certificado mostrado no monitor | Certificado autoassinado. Instale um certificado de confiança (o ACME está integrado no Proxmox) ou ative insecure_tls. A opção nunca é ativada implicitamente. |
| Erro de autenticação | Segredo colado em Token ID (ou o contrário), «Privilege Separation» deixado marcado (o token fica então sem direitos), ou o papel DumbMonit não aplicado em /. |
| Idade da cópia de segurança em falta para um convidado | Nenhuma tarefa vzdump na janela de retrospetiva e nenhum arquivo encontrado nos storages; ou scan_backup_storage desativado. |
| Sondas lentas | Um storage de cópias de segurança que demora a listar, ou muitos convidados a inventariar para snapshots. Desative scan_backup_storage ou scan_snapshots, baixe max_snapshot_guests, ou aumente request_timeout_seconds. |
node_updates_pending em falta | O utilizador ou token não tem Sys.Modify em /nodes. Conceda o papel DumbMonitUpdates do passo 6, ou ignore: node_pve_packages_upgradable e node_reboot_required cobrem os pacotes Proxmox sem ele. |
| Sem percentagem de memória para uma VM | O Proxmox VE 9 reporta, no inventário do cluster, a memória que a VM ocupa no anfitrião — sobrecarga incluída, portanto regularmente acima da sua atribuição. Uma percentagem calculada a partir dela ficaria acima de 100% para sempre. O valor honesto vem do driver balloon dentro do convidado; uma VM com ballooning desativado mostra por isso bytes e nenhuma percentagem. guest_memory_host_bytes é o valor do lado do anfitrião. |
| Sem capacidade para o storage de cópias de segurança | Um datastore Proxmox Backup Server montado no PVE não reporta tamanho: o PVE não o lê. A página do próprio monitor do datastore tem-no. |
| Uso de disco vazio («size only») para uma VM | A VM não tem agente de convidado QEMU (não ativado nas suas opções, ou qemu-guest-agent não instalado no interior), ou o token não tem VM.GuestAgent.Audit. guest_agent_enabled e guest_agent_running dizem qual. Os contentores nunca precisam dele. |
Sem séries node_disk_* | O token não tem Sys.Audit em / (o papel DumbMonit concede-o), ou o nó corre atrás de um controlador RAID que esconde o SMART: disks/list reporta então UNKNOWN e nenhum node_disk_smart_failed é publicado. |
node_packages_changed dispara após um reinício do servidor | Não dispara: a primeira sonda após um reinício apenas aprende as versões. Uma alteração só é reportada entre duas sondas consecutivas do mesmo processo do servidor. |
backup_job_last_ok{job=…} em falta enquanto backup_job_last_ok{node=…} existe | As tarefas vzdump não trazem o id da tarefa (Proxmox VE anterior à 7.2, ou tarefas lançadas à mão). O estado de execução por nó continua lá. |
| Sem métricas de Ceph ou replicação | Nada a reportar: o Ceph não está instalado, ou nenhuma tarefa de replicação está configurada. Não é um erro. |
| Sem thin pool nem grupo de volumes num cartão de nó | A opção lvm está desativada, o nó não tem LVM, ou o utilizador tem Sys.Audit apenas em /nodes — esse inventário pede-o em /. |
| A secção Ceph está em falta enquanto o cluster tem Ceph | ceph ou ceph_detail está desativado, ou todos os nós responderam às chamadas de detalhe com um erro. available: false em /api/targets/{id}/proxmox/ceph significa «aqui não há Ceph», não «ainda não recolhido». |
| Sem sistema operativo nem endereço IP para uma VM | O agente de convidado QEMU não está ativado ou instalado nessa VM, ou o token não tem VM.GuestAgent.Audit no Proxmox VE 8 (passo 7). Os contentores não precisam de agente. Um convidado que acabou de arrancar espera até uma hora: os dados são atualizados de hora a hora, não em cada sonda. |
| Um convidado mantém um distintivo de bloqueio | Uma cópia de segurança, migração ou snapshot interrompidos deixaram-no para trás. qm unlock <vmid> para uma VM, pct unlock <vmid> para um contentor — depois de verificar que a tarefa terminou mesmo. |
pve_backup_excludes_disk dispara numa máquina com CD-ROM | Não dispara: unidades, imagens cloudinit e entradas que não são volumes são excluídas por conceção e nunca reportadas por convidado. O que disparou é um disco real com backup=0. |
Sem séries *_rrd_* | metrics_export está desativado (por predefinição), ou o utilizador não tem Sys.Audit em /. |